Der er en sætning, der falder næsten hver gang AI kommer op i en mindre virksomhed: “Vi skal lige have styr på vores data først.” Den bliver sagt i god tro, og som regel af nogen, der har ret i, at tingene ligger spredt. Regnearket her, systemet der, en mappe på et fællesdrev, som to personer kender indholdet af.
Bag den ligger en antagelse om, at datakvalitet og AI hænger uløseligt sammen, og at det første skal være helt på plads, før det andet overhovedet kan komme i spil. Problemet er, at sætningen sjældent fører nogen steder hen. Ingen virksomhed bliver færdig med at få styr på sine data. Der kommer altid et nyt system, en ny medarbejder med sin egen måde at navngive filer på, en kunde, der ligger i CRM under to forskellige stavemåder. Hvis AI først må komme på tale, når det hele er ryddet op, kommer AI aldrig på tale.
Og i de fleste tilfælde er præmissen ikke engang rigtig.
Hvor kommer forestillingen fra?
Ideen om, at data skal være rene først, stammer fra en helt anden type projekter end dem, de fleste mindre virksomheder står med. I klassiske dataprojekter, hvor en model skal forudsige noget ud fra historik, er datakvalitet alt. Skal et system gætte, hvilke kunder der er på vej til at opsige aftalen, skal det bruge mange års ensartede, korrekte registreringer. Er halvdelen af felterne tomme, eller er “aktiv kunde” defineret forskelligt i to afdelinger, bliver resultatet ubrugeligt.
Det er en rigtig og velbegrundet regel. Den gælder bare for projekter, der handler om at forudsige, score eller analysere store mængder historik. Det er ikke der, de fleste SMV’er får deres første værdi ud af AI.
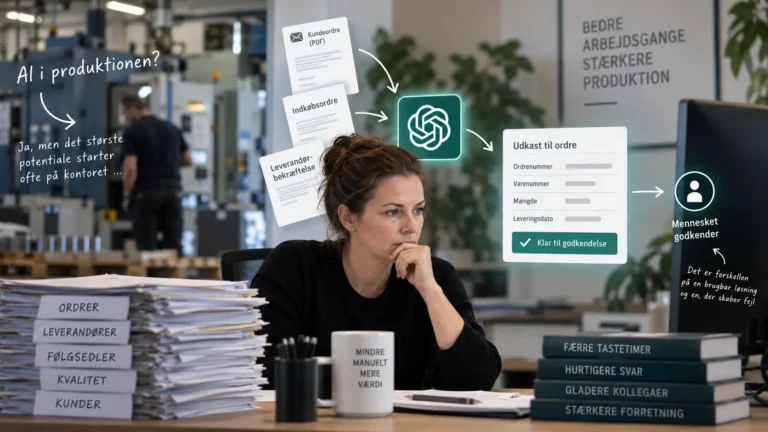
Den type AI, der er blevet tilgængelig for alle de sidste par år, arbejder primært med sprog. Den læser en tekst og producerer en anden tekst. Den har ikke brug for jeres database. Den har brug for det dokument, I giver den lige nu.
Skal jeres data være i orden, før I kan bruge AI?
Nej, ikke til de opgaver, der typisk giver hurtigst værdi. En stor del af det arbejde, AI kan aflaste i en mindre virksomhed, stiller ingen krav til datakvalitet overhovedet, fordi materialet leveres til opgaven i det øjeblik, opgaven udføres.
Tænk på forskellen sådan her: Hvis en ny medarbejder skulle skrive et udkast til et svar på en kundemail, ville I ikke først rydde op i hele CRM-systemet. I ville sende mailen videre og sige, hvad svaret skal indeholde. Det er den samme type opgave, vi taler om.
Opgaver, hvor datakvaliteten sjældent står i vejen
Her er nogle af de opgaver, vi oftest ser løst manuelt i mindre virksomheder, og hvor rod i systemerne ikke er nogen forhindring:
- Omskrivning af tekst, I allerede har. Fx en leverandørs tørre produktbeskrivelse, der skal blive til noget, jeres egne kunder gider læse. Råmaterialet kommer fra leverandøren, ikke fra jeres data. Vi har vist et konkret eksempel i artiklen om AI til produktbeskrivelser i en webshop.
- Opsummering af noget langt. Fx en mailtråd med 22 svar, som en kollega skal overtage i morgen, eller et referat, ingen har tid til at læse.
- Førsteudkast ud fra få stikord. Fx en standardmail, et opslag eller et afsnit til et tilbud, hvor I selv kender indholdet, men bruger tid på at formulere det.
- Find det relevante i et langt dokument. Fx en kontrakt eller et udbudsmateriale, hvor I skal have fat i de fire afsnit, der faktisk betyder noget for jer.
- Oversættelse og sproglig ensretning. Fx når det samme skal ud på dansk og engelsk, og tonen skal være den samme begge steder.
Fælles for dem alle er, at inputtet er noget, en person sidder med i forvejen. Der er ikke noget system, der skal slås op i. Derfor kan I gå i gang i morgen, uanset hvor rodet jeres drev ser ud.
Hvornår er data faktisk problemet?
Datakvalitet bliver afgørende i det øjeblik, AI skal svare ud fra jeres egne oplysninger i stedet for ud fra det, I selv giver den. Det er en reel grænse, og den skal tages alvorligt.
Nogle eksempler, hvor vi ville sige stop.
Når AI skal svare kunder ud fra jeres priser
Findes prislisten i tre versioner, og ved ingen helt, hvilken der gælder, bliver resultatet forkerte priser, sendt hurtigere end før.
Når AI skal slå op i kundedata
Står de samme kunder både i CRM og i et regneark, som en enkelt person vedligeholder ved siden af, kan et automatisk opslag ikke blive rigtigt.
Når der skal rapporteres på tal
Er tallene ikke registreret ens over tid, kan et system ikke regne sig ud af det. Fx hvis “solgt” betød noget andet i 2023 end i dag.
I de tilfælde er oprydningen ikke en undskyldning for at udskyde. Den er selve opgaven, og den skal løses først. Vi vil hellere sige det rent ud end sætte noget i gang, der giver forkerte svar med stor selvsikkerhed.
Men bemærk forskellen. Det er ikke “jeres data skal være i orden, før I kan bruge AI”. Det er “de data, en bestemt opgave trækker på, skal være i orden, før dén opgave kan automatiseres”. Det er en meget mindre oprydning, og den kan prioriteres.
Vend spørgsmålet om, og gør det i tre trin
I stedet for at spørge “er vores data gode nok til AI”, skal I stille spørgsmålet den anden vej rundt. Det kan klares på en formiddag, og I skal hverken tale med en leverandør eller købe noget.
- Find den opgave, der koster mest tid lige nu. Ikke den mest interessante, men den, der fylder mest i kalenderen hos den, der rent faktisk sidder med den.
- Skriv ned, hvilke oplysninger den opgave trækker på. Kommer de i en mail eller et dokument udefra, er der ingen oprydning. Skal de hentes i jeres egne systemer, så notér præcis hvilke.
- Ryd kun op i dét, og kun hvis trin 2 viste et behov. Så er oprydningen pludselig en afgrænset opgave med et formål og en slutdato, ikke et dataprojekt uden ende.
Begge udfald er nyttige. Måske viser det sig, at den tunge opgave er at skrive tilbud, og at alt det, der skal bruges, står i kundens egen mail. Så er der ingen oprydning. Måske viser det sig, at det tunge er at svare på “hvad koster det”, og at prislisten er det egentlige problem. Så ved I nu, hvad den første opgave er, og den har intet med AI at gøre.
Det uklare “vi skal have styr på vores data” giver ingen af delene, fordi det hverken peger på en opgave eller en rækkefølge.
Sådan griber vi det an
Når vi fra AI Create kommer ud i en virksomhed, kigger vi først på arbejdsgangene, ikke på systemerne. Vi vil vide, hvad folk rent faktisk bruger deres dag på, hvor tingene hober sig op, og hvilke opgaver der bliver løst forfra hver gang. Først bagefter kigger vi på, hvilke data de opgaver kræver, og om de findes i en form, der kan bruges.
Det er også derfor, vi ikke kan svare på forhånd, om jeres data er gode nok. Det afhænger fuldstændig af, hvilken opgave I vil løse. En virksomhed med kaotiske drev kan sagtens have fem oplagte AI-opgaver, der ikke rører drevene. En virksomhed med pæn struktur kan have nul, fordi arbejdet ligger et helt andet sted.
Resultatet af en gennemgang er en prioriteret liste, hvor hver mulighed har en vurdering af, hvad den kræver, og hvad den er værd. Den indeholder altid også et afsnit om det, vi ikke anbefaler. Vil I se, hvordan sådan en vurdering ser ud i praksis, ligger der et fiktivt eksempel på en AI-gennemgang af en virksomhed, som I kan læse uden at oplyse jeres mail. Og vil I se, hvad der rent faktisk foregår undervejs, er hele forløbet beskrevet trin for trin, fra workshoppen hos jer til rapporten.
Ofte stillede spørgsmål om datakvalitet og AI
Hvad betyder datakvalitet, når det handler om AI?
Datakvalitet handler om, hvorvidt de oplysninger, en opgave trækker på, er korrekte, ens registreret og til at finde. Det er ikke et spørgsmål om hele virksomhedens data, men om de data, den konkrete opgave bruger.
Skal vi rydde op i CRM, før vi bruger AI?
Kun hvis den opgave, I vil løse, trækker på CRM. Skal AI skrive et udkast til et svar på en kundemail, er mailen nok, men skal den slå kunder op automatisk, skal kundedata være i orden først.
Hvor lang tid tager det at finde ud af, om vores data er gode nok?
En formiddag. Find den opgave, der koster mest tid, skriv ned, hvilke oplysninger den trækker på, og ryd kun op i dem, hvis det viser sig nødvendigt.
Hvad står der på spil?
Hvis intet ændrer sig
Det, der er på spil, er sjældent et tabt projekt. Det er et år, der går. Sætningen om at få styr på data først lyder ansvarlig, og derfor er den svær at sige imod på et møde. Imens bliver de samme tilbud skrevet forfra, de samme mailtråde læst igennem af den næste, der overtager, og den samme leverandørbeskrivelse oversat til noget, kunderne gider læse. Ingen af delene bliver et problem. De bliver bare ved med at koste det samme hver uge.
Når det virker
Den anden vej er heller ikke dramatisk. Det er, at en medarbejder en fredag opdager, at den opgave, hun plejede at bruge to timer på, nu tager tyve minutter. At I tør sige ja til den ekstra kunde, fordi papirarbejdet ikke længere er det, der bremser. Og at når I en dag faktisk skal rydde op i data, ved I hvorfor og hvor meget. Det er en lille forskel om ugen og en stor forskel om et år.
Hvis I genkender sætningen
Hvis “vi skal lige have styr på vores data først” har stået i referatet fra flere møder i træk, er det værd at undersøge, om det passer. Nogle gange gør det. Oftere er det en rimelig bekymring, der har fået lov at blokere for opgaver, den slet ikke gælder for.
Vi taler gerne om, hvor I står. Book en uforpligtende samtale på 20 til 30 minutter, så kigger vi på, hvad I bruger tiden på, og om der overhovedet er noget, der skal ryddes op i først.